

映像コース

- 映像コース 記事一覧
- 【映像コース】AIはなぜ“指を6本”描いてしまうのか? 〜生成AIのハルシネーションとディフュージョンモデルのしくみ〜
2026年10月20日
【映像コース】AIはなぜ“指を6本”描いてしまうのか? 〜生成AIのハルシネーションとディフュージョンモデルのしくみ〜
こんにちは、映像コースの冨士川です。
「ハルシネーション」という言葉、聞いたことありますよね?
生成AIが、もっともらしい顔をして平然と嘘をつく、アレです。
ChatGPTなどの文章生成AIに質問したら、存在しない論文や架空の人物をそれらしく紹介された──そんな経験をした方もいるのではないでしょうか。
画像生成AIにも同じような現象があります。人物の手を描かせたら指が6本あった。街並みを描かせたら、看板の文字が読めそうで読めない謎の記号になっていた。一見とてもリアルなのに、よく見るとどこかおかしい。これも一種のハルシネーションです。
では、なぜそんなことが起こるのか、知っていますか?
今回は、画像生成AIの多くが採用している「ディフュージョンモデル(拡散モデル)」というしくみから、その理由をひもといてみたいと思います。
ハルシネーションは、英語で「幻覚」を表す言葉です。AIの世界では、事実と違う内容や現実にはあり得ないものを、AIがさも本当のことのように出力してしまう現象をハルシネーションと呼んでいます。
ポイントは、AIに「嘘をついている」という自覚がまったくないことです。AIは悪意を持ってごまかしているわけでも、うっかり間違えているわけでもありません。そもそも、「正しいかどうか」を基準に答えを作っていないのです。
このことを理解するために、画像生成AIの中身をのぞいてみましょう。
現在の画像生成AIの多くは「ディフュージョンモデル」と呼ばれる技術をベースにしています。大雑把に説明すると、「ノイズだらけの画像から、少しずつノイズを取り除いて絵を浮かび上がらせるしくみ」です。
① 学習:きれいな画像をわざと壊していく
まずAIは、大量の画像とその説明文(「海辺を歩く犬」など)のペアを使って学習します。このとき、きれいな画像に少しずつノイズ(ザラザラした砂粒のような乱れ)を加えていき、最終的には何が写っていたのかまったく分からない状態にします。ちょうど、アナログテレビの「砂嵐」のような画面です。
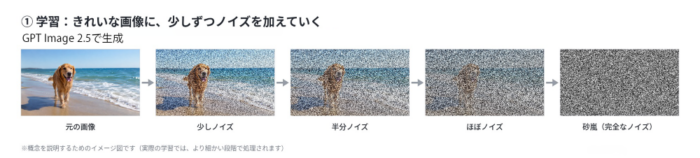 そしてAIは、その逆──「ノイズが乗った画像から、乗っているノイズを推測して取り除く」練習を何億回と繰り返します。「この説明文の画像なら、この砂嵐の中にはこういう形が隠れているはずだ」という推測の精度を上げていくわけです。
② 生成:砂嵐から絵を“掘り出す”
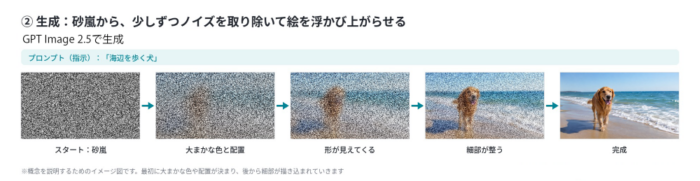
実際に画像を作るときは、この逆の工程を走らせます。最初にあるのは、完全にランダムな砂嵐だけです。そこに「海辺を歩く犬」という指示(プロンプト)を手がかりにして、「このあたりは犬の輪郭っぽい」「ここは波っぽい」とノイズを少し取り除く。それを数十回繰り返すうちに、だんだんと犬と海辺の絵が浮かび上がってきます。
ここで大切なのは、この工程のどこにも「考える」というステップがないことです。
人間がデッサンをするときは、まず観察から始めます。「手には指が5本ある」「親指は他の4本と向きが違う」「関節はこう曲がる」という構造を理解したうえで描き上げていきます。
一方、ディフュージョンモデルがやっているのは、「このプロンプトなら、画面のこのあたりのピクセルはこういう色や形になっていることが多い」という統計的なパターンの再現です。手を描いているときも「指は5本」という知識を参照しているわけではありません。「手っぽい場所には、細長い棒状の形が並んでいることが多い」というパターンに沿って、ノイズを整えているだけなのです。
文章生成AI(LLM)も本質は同じです。「この言葉の次には、どんな言葉が来ることが多いか」を予測してつなげているだけで、内容を理解しているわけではありません。だから、もっともらしい嘘が生まれるのです。
このしくみが分かると、ハルシネーションの理由が見えてきます。
指が6本になる理由
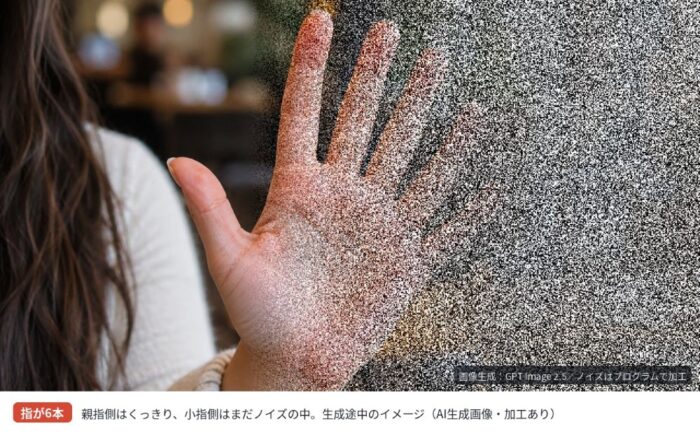
手は、写真の中では小さく写ることが多く、しかも握る・重なる・物を持つなど形のバリエーションが非常に多いパーツです。指が隠れて3本しか見えない写真もあれば、両手が重なって片手の指が6本以上に見えることもあります。
AIが学んでいるのは「指っぽい細長い形が並ぶ」という局所的なパターンで、「全部で何本か」という構造を理解しているわけではありません。その結果、それぞれの指は自然に見えるのに、数えてみると6本、ということが起こるのです。
文字が崩れる理由
文字も同じです。AIは大量の画像から「看板などにはこういう線の集まりが描かれている」ことを学んでいますが、文字を「読める記号」として理解しているわけではありません。だから、文字っぽいけれど読めない、謎の記号が生まれます。
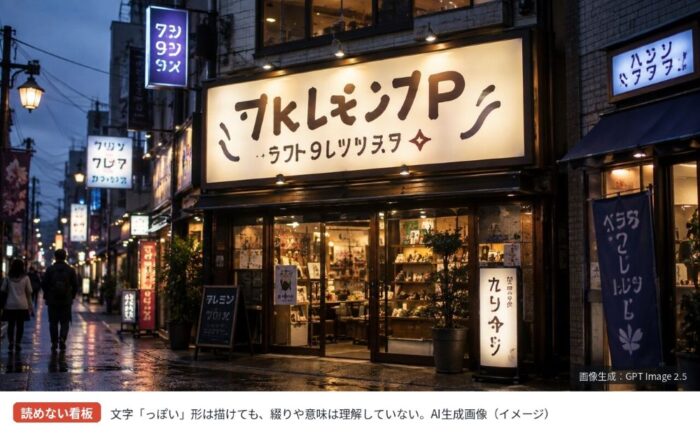 最近の画像生成AIは、学習データやモデルの改良によって、手や文字をかなり正確に描けるようになってきました。ただしそれは、パターンを再現する精度が上がったということであって、ディフュージョンモデルは「指の構造を理解した」わけでも「文字が読めるようになった」わけでもありません。条件が難しくなれば、同じような破綻は今でも起こります。
ではAIは信用できない道具なのでしょうか? 私はそうは思いません。大切なのは、AIがどうやって画像を作っているのかを知ったうえで使うことです。
これは、このブログで以前紹介した撮影テクニックの話と同じです。カメラのしくみや画面サイズのセオリーを知っている人は、カメラが得意なこと・苦手なことを踏まえて撮影できます。AIも同じで、しくみを知っていれば、正しい使い方が可能になるはずです。
AIを使ううえで気をつけなければならないのは、ハルシネーションだけではありません。特に作品を発表したり、仕事で使ったりする場合に大切なのが、著作権をはじめとする「権利」の問題です。
AIは膨大な画像から学習しているため、プロンプト次第では既存の作品やキャラクターにそっくりな画像が出てくることがあります。日本では、AIの学習そのものは原則として著作権者の許諾なく行えるとされていますが、生成した画像を公開・利用する段階では、人間が描いた作品と同じように判断されます。つまり、既存の作品と似ている「類似性」、その作品をもとにしている「依拠性」が認められると、著作権侵害になりうるということです。
特に「〇〇○(作家名・作品名)風に」「□□□(キャラクター名)を描いて」といった、特定の作品をイメージしたプロンプトは要注意です。
そして、AIを使った場合は隠さず、「どこに・どのように使ったのか」を説明できるようにしておくことが、作り手としての信頼につながります。
権利やルールの話は「面倒な制約」に見えるかもしれませんが、AIを利用するうえでの前提条件だと考えておくことが重要です。
今、文章や画像、映像、音楽など、生成AIで作品を作る人がどんどん増えています。では、AIを本当に「使いこなせている」人は、どのくらいいるのでしょうか。
生成AIのおかげで、「それっぽいもの」を作るハードルはほぼゼロになりました。でも、それっぽい作品が作れることと、AIを使いこなしていることは、まったく別のことです。むしろ、誰でもそれっぽいものが作れるようになったからこそ、その違いが作品の質の差になって表れます。そして、その差を生むのは「AIの操作スキル」ではなく、ほとんどが「作り手としての基礎力」です。AIが代わりにやってくれるのは手を動かす部分であって「何を作るのか?」「これで良いのか?」を決める部分は、むしろ人間の役割としてますます重くなってきています。これまで、このブログで紹介してきたイマジナリーラインや画面サイズといった撮影のセオリーも、まさにこの「作り手としての基礎力」です。AIの時代だからこそ、基礎を学ぶ意味はますます大きくなっていると、私は考えています。
京都芸術大学は、生成AIを禁止するのではなく「学問的誠実性に反しない限り、制作・研究での実証的な利用を積極的に推進する」という方針を全学で掲げています。条件は、作品やレポートの主要部分をAIに代替させないこと、そしてAIを何にどう使ったかを明示することです。
この方針のもと、10月から総合教育科目「AIリテラシーの扉」が始まりました。通信教育部の学生なら誰でも履修できる講義です。AIを「便利な道具」や「脅威」としてではなく、「人間の創造性とは何か」を映す鏡として捉え、生成AIと向き合うための柔軟な思考と創造性、そして誠実さを育むことを目指しています。私も全15章のうち、「生成AIと創作」と題した2章を担当しています。
一方で、映像コースでは、生成AIの利用を原則として禁止しています。矛盾しているように見えるかもしれませんが、目指すところは同じです。AIは、それらしいものを驚くほど上手に描きます。けれども、何がよくて何が足りないのかを見極めるのは、いまも人間の側の仕事です。その目と手を持たないままAIを使えば、道具に使われることになってしまう。だからこそ、在学中はまず作り手としての基礎力をしっかり身につけてほしいのです。
生成AIを使うか、使わないか。本当に問われているのは、その二択ではありません。AIを使いこなせる「作り手」をどう育てるか。それが、いま私たちが向き合っている問いです。
映像コース| 学科・コース紹介
 大学パンフレット資料請求はこちらから
「ハルシネーション」という言葉、聞いたことありますよね?
生成AIが、もっともらしい顔をして平然と嘘をつく、アレです。
ChatGPTなどの文章生成AIに質問したら、存在しない論文や架空の人物をそれらしく紹介された──そんな経験をした方もいるのではないでしょうか。
画像生成AIにも同じような現象があります。人物の手を描かせたら指が6本あった。街並みを描かせたら、看板の文字が読めそうで読めない謎の記号になっていた。一見とてもリアルなのに、よく見るとどこかおかしい。これも一種のハルシネーションです。
では、なぜそんなことが起こるのか、知っていますか?
今回は、画像生成AIの多くが採用している「ディフュージョンモデル(拡散モデル)」というしくみから、その理由をひもといてみたいと思います。
目次
ハルシネーションとは?
ハルシネーションは、英語で「幻覚」を表す言葉です。AIの世界では、事実と違う内容や現実にはあり得ないものを、AIがさも本当のことのように出力してしまう現象をハルシネーションと呼んでいます。
ポイントは、AIに「嘘をついている」という自覚がまったくないことです。AIは悪意を持ってごまかしているわけでも、うっかり間違えているわけでもありません。そもそも、「正しいかどうか」を基準に答えを作っていないのです。
このことを理解するために、画像生成AIの中身をのぞいてみましょう。
画像生成AIはどうやって絵を作っているのか?
現在の画像生成AIの多くは「ディフュージョンモデル」と呼ばれる技術をベースにしています。大雑把に説明すると、「ノイズだらけの画像から、少しずつノイズを取り除いて絵を浮かび上がらせるしくみ」です。
① 学習:きれいな画像をわざと壊していく
まずAIは、大量の画像とその説明文(「海辺を歩く犬」など)のペアを使って学習します。このとき、きれいな画像に少しずつノイズ(ザラザラした砂粒のような乱れ)を加えていき、最終的には何が写っていたのかまったく分からない状態にします。ちょうど、アナログテレビの「砂嵐」のような画面です。
そしてAIは、その逆──「ノイズが乗った画像から、乗っているノイズを推測して取り除く」練習を何億回と繰り返します。「この説明文の画像なら、この砂嵐の中にはこういう形が隠れているはずだ」という推測の精度を上げていくわけです。② 生成:砂嵐から絵を“掘り出す”
実際に画像を作るときは、この逆の工程を走らせます。最初にあるのは、完全にランダムな砂嵐だけです。そこに「海辺を歩く犬」という指示(プロンプト)を手がかりにして、「このあたりは犬の輪郭っぽい」「ここは波っぽい」とノイズを少し取り除く。それを数十回繰り返すうちに、だんだんと犬と海辺の絵が浮かび上がってきます。
AIは「考えて」描いているわけではない
ここで大切なのは、この工程のどこにも「考える」というステップがないことです。
人間がデッサンをするときは、まず観察から始めます。「手には指が5本ある」「親指は他の4本と向きが違う」「関節はこう曲がる」という構造を理解したうえで描き上げていきます。
一方、ディフュージョンモデルがやっているのは、「このプロンプトなら、画面のこのあたりのピクセルはこういう色や形になっていることが多い」という統計的なパターンの再現です。手を描いているときも「指は5本」という知識を参照しているわけではありません。「手っぽい場所には、細長い棒状の形が並んでいることが多い」というパターンに沿って、ノイズを整えているだけなのです。
文章生成AI(LLM)も本質は同じです。「この言葉の次には、どんな言葉が来ることが多いか」を予測してつなげているだけで、内容を理解しているわけではありません。だから、もっともらしい嘘が生まれるのです。
だから「指が6本になる」「文字が崩れる」
このしくみが分かると、ハルシネーションの理由が見えてきます。
指が6本になる理由
手は、写真の中では小さく写ることが多く、しかも握る・重なる・物を持つなど形のバリエーションが非常に多いパーツです。指が隠れて3本しか見えない写真もあれば、両手が重なって片手の指が6本以上に見えることもあります。
AIが学んでいるのは「指っぽい細長い形が並ぶ」という局所的なパターンで、「全部で何本か」という構造を理解しているわけではありません。その結果、それぞれの指は自然に見えるのに、数えてみると6本、ということが起こるのです。
文字が崩れる理由
文字も同じです。AIは大量の画像から「看板などにはこういう線の集まりが描かれている」ことを学んでいますが、文字を「読める記号」として理解しているわけではありません。だから、文字っぽいけれど読めない、謎の記号が生まれます。
最近の画像生成AIは、学習データやモデルの改良によって、手や文字をかなり正確に描けるようになってきました。ただしそれは、パターンを再現する精度が上がったということであって、ディフュージョンモデルは「指の構造を理解した」わけでも「文字が読めるようになった」わけでもありません。条件が難しくなれば、同じような破綻は今でも起こります。AIを上手に使うために
ではAIは信用できない道具なのでしょうか? 私はそうは思いません。大切なのは、AIがどうやって画像を作っているのかを知ったうえで使うことです。
これは、このブログで以前紹介した撮影テクニックの話と同じです。カメラのしくみや画面サイズのセオリーを知っている人は、カメラが得意なこと・苦手なことを踏まえて撮影できます。AIも同じで、しくみを知っていれば、正しい使い方が可能になるはずです。
ハルシネーション以外にも気をつけること
AIを使ううえで気をつけなければならないのは、ハルシネーションだけではありません。特に作品を発表したり、仕事で使ったりする場合に大切なのが、著作権をはじめとする「権利」の問題です。
AIは膨大な画像から学習しているため、プロンプト次第では既存の作品やキャラクターにそっくりな画像が出てくることがあります。日本では、AIの学習そのものは原則として著作権者の許諾なく行えるとされていますが、生成した画像を公開・利用する段階では、人間が描いた作品と同じように判断されます。つまり、既存の作品と似ている「類似性」、その作品をもとにしている「依拠性」が認められると、著作権侵害になりうるということです。
特に「〇〇○(作家名・作品名)風に」「□□□(キャラクター名)を描いて」といった、特定の作品をイメージしたプロンプトは要注意です。
そして、AIを使った場合は隠さず、「どこに・どのように使ったのか」を説明できるようにしておくことが、作り手としての信頼につながります。
権利やルールの話は「面倒な制約」に見えるかもしれませんが、AIを利用するうえでの前提条件だと考えておくことが重要です。
「それっぽい」と「使いこなす」の違い
今、文章や画像、映像、音楽など、生成AIで作品を作る人がどんどん増えています。では、AIを本当に「使いこなせている」人は、どのくらいいるのでしょうか。
生成AIのおかげで、「それっぽいもの」を作るハードルはほぼゼロになりました。でも、それっぽい作品が作れることと、AIを使いこなしていることは、まったく別のことです。むしろ、誰でもそれっぽいものが作れるようになったからこそ、その違いが作品の質の差になって表れます。そして、その差を生むのは「AIの操作スキル」ではなく、ほとんどが「作り手としての基礎力」です。AIが代わりにやってくれるのは手を動かす部分であって「何を作るのか?」「これで良いのか?」を決める部分は、むしろ人間の役割としてますます重くなってきています。これまで、このブログで紹介してきたイマジナリーラインや画面サイズといった撮影のセオリーも、まさにこの「作り手としての基礎力」です。AIの時代だからこそ、基礎を学ぶ意味はますます大きくなっていると、私は考えています。
さいごに
京都芸術大学は、生成AIを禁止するのではなく「学問的誠実性に反しない限り、制作・研究での実証的な利用を積極的に推進する」という方針を全学で掲げています。条件は、作品やレポートの主要部分をAIに代替させないこと、そしてAIを何にどう使ったかを明示することです。
この方針のもと、10月から総合教育科目「AIリテラシーの扉」が始まりました。通信教育部の学生なら誰でも履修できる講義です。AIを「便利な道具」や「脅威」としてではなく、「人間の創造性とは何か」を映す鏡として捉え、生成AIと向き合うための柔軟な思考と創造性、そして誠実さを育むことを目指しています。私も全15章のうち、「生成AIと創作」と題した2章を担当しています。
一方で、映像コースでは、生成AIの利用を原則として禁止しています。矛盾しているように見えるかもしれませんが、目指すところは同じです。AIは、それらしいものを驚くほど上手に描きます。けれども、何がよくて何が足りないのかを見極めるのは、いまも人間の側の仕事です。その目と手を持たないままAIを使えば、道具に使われることになってしまう。だからこそ、在学中はまず作り手としての基礎力をしっかり身につけてほしいのです。
生成AIを使うか、使わないか。本当に問われているのは、その二択ではありません。AIを使いこなせる「作り手」をどう育てるか。それが、いま私たちが向き合っている問いです。
映像コース| 学科・コース紹介
大学パンフレット資料請求はこちらから
 X
 Facebook
 LINE
おすすめ記事
-
映像コース
2026年09月15日
【映像コース】スマホで撮影した映像から、映像の多彩さにふれる
みなさん、こんにちは。映像コース研究室の鮫島です。 京都はすこしずつ空気が涼しくなってまいりました、みなさんがお住まいの地域ではいかがでしょうか。 今回は、スマ…
-
映像コース
2026年08月20日
【映像コース】創造することについて 宇多田ヒカルとユヴァル・ノア・ハラリの対談動画「創造するということを、改めて考えてみる。」
こんにちは、映像コース研究室の下川です。 今日は、YouTubeで見ることができる素敵な対談動画をご紹介しながら、「創造すること」について考える時間にしたいと思…
-
映像コース
2026年07月17日
【映像コース】架空の放送局を即興で作る
こんにちは。映像コースの丹下紘希です。 本格的な夏がやってきました。暑い日が続いていますが、みなさん体調など崩されていないでしょうか。 7月4日・5日の二日間、…